
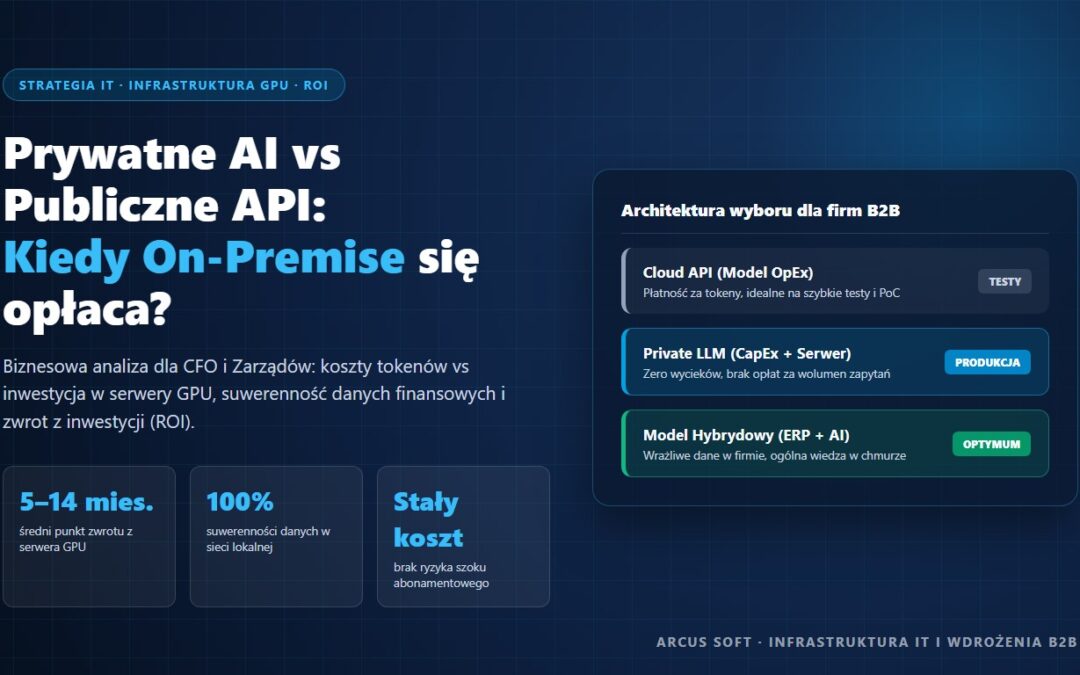
Wybór pomiędzy komercyjnym Cloud API (płatnym za zużycie tokenów) a prywatnym modelem LLM (uruchamianym na własnym serwerze GPU lub w chmurze prywatnej) stanowi kluczowy dylemat budżetowy i architektoniczny dla zarządów oraz dyrektorów IT. Dynamiczny wzrost liczby zapytań sprawia, że koszty subskrypcyjne w chmurze publicznej rosną liniowo, podczas gdy regulacje prawne (RODO, NIS2, DORA, EU AI Act) stawiają twarde bariery przed wysyłaniem poufnych danych finansowych na zewnętrzne serwery.
Poniższy artykuł analizuje modele kosztowe, przedstawia realną kalkulację zwrotu z inwestycji (ROI) oraz wskazuje kryteria wyboru właściwej architektury sztucznej inteligencji w średnim i dużym przedsiębiorstwie.
1. Dwa modele ekonomiczne: OpEx (chmura) vs CapEx (On-Premise)
Decyzja technologiczna przekłada się bezpośrednio na strukturę bilansu przedsiębiorstwa:
Model Cloud API (OpEx – koszty operacyjne)
- Mechanizm rozliczeń: Płatność za milion przetworzonych tokenów (wejściowych i wyjściowych).
- Zalety: Zerowy koszt startowy infrastruktury, natychmiastowe uruchomienie w testach i faza Proof of Concept (PoC).
- Ograniczenia finansowe: Koszty rosną wraz z adopcją narzędzi w firmie. Jeśli setki pracowników codziennie przetwarzają faktury, umowy czy bazy wiedzy w systemach RAG, miesięczne rachunki rosną nieprzewidywalnie. Firma narażona jest na ryzyko vendor lock-in oraz jednostronne zmiany cenników dostawców chmurowych.
Model Private LLM / On-Premise (CapEx + stałe OpEx)
- Mechanizm rozliczeń: Jednorazowa inwestycja w sprzęt serwerowy z akceleratorami GPU (lub stały wynajem dedykowanych instancji GPU) oraz instalacja modeli open-weight (np. Llama, Mistral, Qwen).
- Zalety: Koszt stały, całkowicie niezależny od liczby wygenerowanych odpowiedzi. Przy dużej skali przetwarzania koszt jednostkowego zapytania spada niemal do kosztu zużytej energii elektrycznej.
- Wymogi: Konieczność wygospodarowania budżetu inwestycyjnego na start oraz posiadanie kompetencji administracyjnych w zakresie zarządzania serwerem.

2. Kalkulacja ROI: Kiedy serwer GPU zwraca się firmie?
Przejście na własną infrastrukturę GPU ma uzasadnienie ekonomiczne, gdy wolumen przetwarzania przekracza próg opłacalności chmury.
- Koszt infrastruktury lokalnej: Profesjonalny serwer przeznaczony do inferencji modeli klasy 8B–70B (wyposażony w dedykowane karty enterprise, np. z serii NVIDIA L40S lub stacje robocze z architekturą Ada Lovelace) to wydatek rzędu kilkudziesięciu tysięcy złotych lub stały koszt kolokacji rzędu 2–4 tys. zł miesięcznie.
- Punkt przełamania (Break-Even Point): Przy intensywnym wykorzystaniu AI w organizacji (od kilkunastu do kilkudziesięciu milionów tokenów miesięcznie – co odpowiada codziennej pracy działu handlowego, księgowości i wsparcia klienta), inwestycja w prywatny serwer zwraca się średnio po 5–14 miesiącach.
- Po osiągnięciu punktu zwrotu generowanie kolejnych milionów tokenów nie generuje dodatkowych obciążeń fakturami API.
3. Bezpieczeństwo i suwerenność danych: Argument pozakosztowy
W sektorach B2B, przemyśle i finansach czynniki regulacyjne często przeważają nad samą kalkulacją sprzętową:
- Tajemnica przedsiębiorstwa i brak wycieku: Dane finansowe, marże, bazy kontrahentów oraz kody źródłowe nie opuszczają sieci lokalnej przedsiębiorstwa (Zero Data Transfer).
- Zgodność z RODO i brak transferu transgranicznego: W modelu On-Premise nie występuje problem przekazywania danych osobowych do podmiotów zlokalizowanych w jurysdykcjach poza EOG ani konieczność podpisywania zewnętrznych umów powierzenia (art. 28 RODO) z zagranicznymi dostawcami chmur.
- Zgodność z regulacjami sektorowymi (DORA / NIS2): Instytucje finansowe, operatorzy usług kluczowych oraz podmioty z łańcuchów dostaw podlegające dyrektywom o odporności cyfrowej muszą gwarantować ciągłość działania i pełną kontrolę nad łańcuchem podwykonawców IT.
4. Model Hybrydowy: Najlepsza praktyka wdrożeniowa
Dla większości przedsiębiorstw optymalnym podejściem nie jest skrajny wybór „wyłącznie chmura” albo „wyłącznie własna serwerownia”, lecz architektura hybrydowa:
Wrażliwe dane firmy (Faktury / Baza ERP / Umowy) > Lokalny serwer GPU (Private LLM / Agenci ERP)
Zadania ogólne (Kreatywne teksty / Analiza publiczna) > Szyfrowane Cloud API- Operacje wewnętrzne na danych wrażliwych: Przetwarzanie wyciągów bankowych, kategoryzacja e-faktur KSeF oraz zapytania wewnątrz bazy Comarch ERP realizowane są przez lokalnych agentów w sieci firmowej bez prawa opuszczania zapory ogniowej.
- Operacje zewnętrzne: Zadania wymagające gigantycznej wiedzy ogólnej lub zaawansowanego wnioskowania logicznego routowane są do modeli chmurowych po wcześniejszej automatycznej anonimizacji promptu.
| Kryterium oceny | Cloud API (Chmura publiczna) | Private LLM (On-Premise / Private Cloud) |
|---|---|---|
| Początkowy próg wejścia | Bardzo niski (brak CapEx) | Średni / Wysoki (zakup serwera GPU) |
| Koszt przy dużej skali | Bardzo wysoki (płatność za każdy token) | Minimalny (koszt stały sprzętu i prądu) |
| Przewidywalność budżetu | Zmienna, ryzyko przekroczenia limitów | 100% stała (amortyzacja + utrzymanie) |
| Lokalizacja danych | Zewnętrzne serwery dostawcy API | Własna serwerownia / lokalna sieć LAN |
| Niezależność technologiczna | Zależność od polityki dostawcy | Pełna kontrola nad wersją modelu i wagami |
| Gotowość na audyt RODO | Wymaga DPA i kontroli transferu | Pełna zgodność w ramach wewnętrznej sieci |
Jak Arcus Soft wdraża bezpieczną infrastrukturę AI w przedsiębiorstwach
Wdrożenie prywatnych modeli językowych wymaga precyzyjnego doboru sprzętu serwerowego, konfiguracji środowiska inferencyjnego oraz integracji ze strukturami bazodanowymi ERP.
Inżynierowie Arcus Soft realizują pełny cykl wdrożeniowy:
- Analiza wolumenu i audyt opłacalności: Wyliczamy dokładny punkt zwrotu z inwestycji (ROI) w oparciu o profil danych i przewidywane zapotrzebowanie firmy.
- Dobór i dostawa infrastruktury serwerowej: Konfigurujemy serwery z akceleratorami GPU dedykowanymi do ciągłej pracy w środowiskach biznesowych.
- Wdrożenie modeli open-weight i RAG: Instalujemy i optymalizujemy modele (Llama, Mistral) wraz z lokalnymi bazami wektorowymi przeszukującymi dokumentację firmową.
- Integracja z Comarch ERP Optima i XL: Łączymy narzędzia analityczne z bazami MS SQL w bezpiecznej architekturze Human-in-the-Loop.
Zbuduj prywatne i bezpieczne środowisko AI z Arcus Soft
Zabezpiecz firmowe know-how i zatrzymaj rosnące rachunki za chmurę. Eksperci Arcus Soft dobiorą infrastrukturę GPU, wdrożą prywatne modele LLM i połączą je z Twoim systemem ERP.
- Szczegółowa kalkulacja TCO i ROI (Cloud API vs On-Premise GPU).
- Dostawa, instalacja i hardening dedykowanych serwerów AI.
- Wdrożenie lokalnych asystentów RAG dla działów sprzedaży, kadr i finansów.
- Bezpieczna integracja z bazami Comarch ERP bez wysyłania danych na zewnątrz.
Skonsultuj architekturę AI i kalkulację ROI z inżynierem Arcus Soft →